Appearance
虚拟 2D 开播面捕失败复盘
面捕启动失败本身只影响少量用户,真正把它放大成事故的是:发版当晚我不在场,线上反馈没人接。这次事故由我个人的失误导致,复盘也先从我自己的问题说起。
止血动作回滚
流程缺口2 个
改进项4 条机制
背景
B 站 PC 端虚拟 2D 开播项目,我作为技术 owner 负责 CV 面捕替换:用新的面捕方案替换原有实现,覆盖 Steam(PrprLive)和直播姬(LiveHime)两个出包平台。面捕是开播链路的入口能力——它起不来,主播的虚拟形象就是一块静止的立绘。
事故发生在 2023 年 4 月底的一次版本发布:上线后多名用户反馈面捕启动失败,而线上问题没有得到及时回复和处理。
事故时间线
| 阶段 | 发生了什么 | 问题在哪 |
|---|---|---|
| 发版前测试 | 自测和外部测试都跑了,但样本量小 | 失败场景没被覆盖,带病发版 |
| 发版当天 | 版本发布,我没有和产品确认实际发版时间 | 不知道当晚就是发版窗口 |
| 发版当晚 | 多名用户面捕启动失败,线上反馈涌入 | 我外出参加活动,无人响应 |
| 次日 | 回滚版本,拉用户日志,与合作方联合排查 | 止血比本该的时间晚了一夜 |
| 修复后 | 冒烟测试通过,重新确认上线日期并发布 | 上线后持续观察,无复发 |
问题
表面问题
- 多名用户面捕启动失败。具体影响面当时没有沉淀成数据(复盘时列为待办,需要找数据侧收集),这本身就是一个问题。
- 线上问题没有及时回复、跟进和处理。
深层问题
- 测试流程缺口:少量用户才暴露的面捕问题,本质是测试样本量不足。小样本通过了,就误以为覆盖了关键场景。
- 发版沟通缺口:没有充分掌握实际发版时间,发版当晚人在外面,既感知不到问题,也处理不了问题。响应机制完全依赖"我刚好在线"。
根因
这不是一个面捕算法的技术 bug 那么简单,而是两条流程链路同时失效:
mermaid
flowchart TD
    A["测试样本量不足"] --> B["面捕启动失败场景<br>未被发现"]
    B --> C["带病版本发布"]
    D["未确认实际发版时间"] --> E["发版当晚不在场"]
    C --> F["用户面捕启动失败"]
    E --> G["线上反馈无人响应"]
    F --> H["故障影响被放大"]
G --> H两条链各自独立,但叠加在一起才构成事故:只有第一条,是个小范围功能 bug;加上第二条,才变成"用户出了问题找不到人"的线上事故。
止血
- 回滚至上一个版本,先恢复用户可用状态,不带着猜测在线上调。
- 获取用户日志数据,确认各用户面捕启动失败的具体情况,划清影响面。
- 与合作方一起定位技术问题——面捕链路涉及外部 SDK,单方猜不如双方对着日志查。
- 修复后通过冒烟测试确认上线日期,再发版。
- 二次上线后持续关注异常情况,确认无复发。
长期改进
事故处理完之后,落到四条机制上:
- 发版即值班:重要时间节点与产品保持多频沟通,发版当天必须有人在岗响应,不允许"发了就走"。
- 测试样本是底线:无论自测还是外部测试,都要覆盖事先定义的关键样本集,样本不够就不能放版。
- 应急响应不依赖单个人:提前备好用户日志收集方式、bug 复现步骤和应急联系人,任何人接手都能处理。
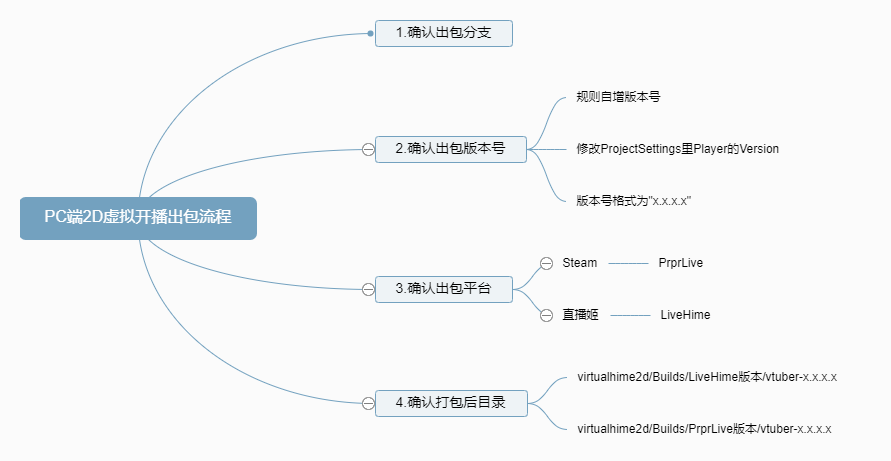
- 出包流程 SOP 化:把出包的分支确认、版本号规则、平台选择、产物目录固化成 checklist,减少每次发版的自由发挥空间。
关键实现
止血动作里有几步值得展开:
- 回滚而不是热修:面捕是开播入口,带着猜测在线上调的代价远高于回滚。先恢复可用状态,把排查放到线下做。
- 日志先行:修复之前先拿到各用户的日志,确认失败发生在启动链路的哪一段、影响面多大,避免"修了一个用户的个案就宣布解决"。
- 冒烟测试守门:修复后不直接发布,先跑一轮覆盖开播主流程的冒烟测试,再和产品确认上线日期——把"什么时候发"从口头同步变成明确的 checklist 项。
- 出包 SOP:上面那张出包流程图就是这次事故后固化的产物——确认分支、确认版本号(自增规则 + 工程内 Version 字段)、确认平台(Steam/PrprLive 与直播姬/LiveHime 产物分开)、确认产物目录。四步每步都有明确产出物,发版不再靠记忆。
指标
这次事故的量化数据留存得不好,如实记录:
- 处置动作可量化:1 次回滚、1 轮冒烟测试、5 步处置流程、4 条机制改进。
- 用户失败量级当时没有收集成数(原复盘里就标了待办),这是本次复盘本身暴露的问题——没有数据留存的复盘,下次连影响面都说不清。
复盘
- 我在原复盘里写的第一句话是"这次事故由我个人的错误导致"。现在看,个人认错只能解释当晚,机制建设才能解释以后:如果我那天在岗但测试样本依然不够,问题还是会上线。
- 小流量功能的测试最容易被"看着没问题"糊弄过去。样本量不是流程繁文缛节,是质量的物理下限。
- "响应不及时"从来不是一个态度问题,而是一个排班问题。凡是依赖某个人恰好在场的机制,迟早会在他不在场的那天失效。