Appearance
Mediapipe 面捕解算器
基于 Mediapipe 478 个面部关键点位,自研「归纳 + 滤波」解算器,输出稳定可靠的 15 个 BlendShape,面捕模块 CPU 占用从 50% 降到 10%。
输入478 点位
输出15 个 BS
CPU 占用50% → 10%
背景
B 站要做 3D 虚拟人直播,面捕是最核心的模块。调研了一圈开源方案后选了 Mediapipe:兼顾面捕和动捕、支持多端、有 Google 背书。但 Mediapipe 只解决「检测」问题——它每帧吐出 478 个面部关键点坐标,不输出任何表情值。当时市面上没有一款开源的、能把 Mediapipe 特征点数组归纳成 BlendShape 的算法,这层只能自己写。
我负责的就是这层面捕解算器:把点位数据变成模型能直接消费的表情数据。
问题
- 点位不是表情:Mediapipe 给的是 478 个坐标,模型驱动需要的是 BlendShape 权重(0~1),中间缺一整套推导算法。
- 没有旋转角:Mediapipe 不输出头部旋转,要从关键点位反推 pitch / yaw / roll。
- 原始数据抖动:摄像头噪声、光照变化、帧间差异都会让推导出的 BS 值高频跳动,直接驱动模型就是「脸在抽搐」。
- 性能预算紧:面捕要在 CPU 上实时跑,初版实现吃掉 50% CPU,直播场景不可接受。
方案
整体数据流
mermaid
flowchart LR
    A["相机模块<br>UnityMediapipePlugin"] -->|"纹理流"| B["Mediapipe 引擎<br>推理"]
    B -->|"478 Landmarks"| C["归纳模块<br>MediapipeAdaptor"]
    C -->|"原始 BS"| D["滤波模块<br>卡尔曼 + 低通"]
    D -->|"稳定 BS"| E["CompatibleFaceBlendShape"]
E --> F["驱动模块<br>VRM / Live2D / AR 头套"]相机模块每帧输出纹理流,Mediapipe 引擎处理后输出 Landmarks 特征点数据集;归纳模块(对应代码里的 MediapipeAdaptor)把特征点归纳为原始 BS 数据集;滤波模块把原始 BS 处理成平滑稳定的 BS,最后经 CompatibleFaceBlendShape 协议交给驱动模块。
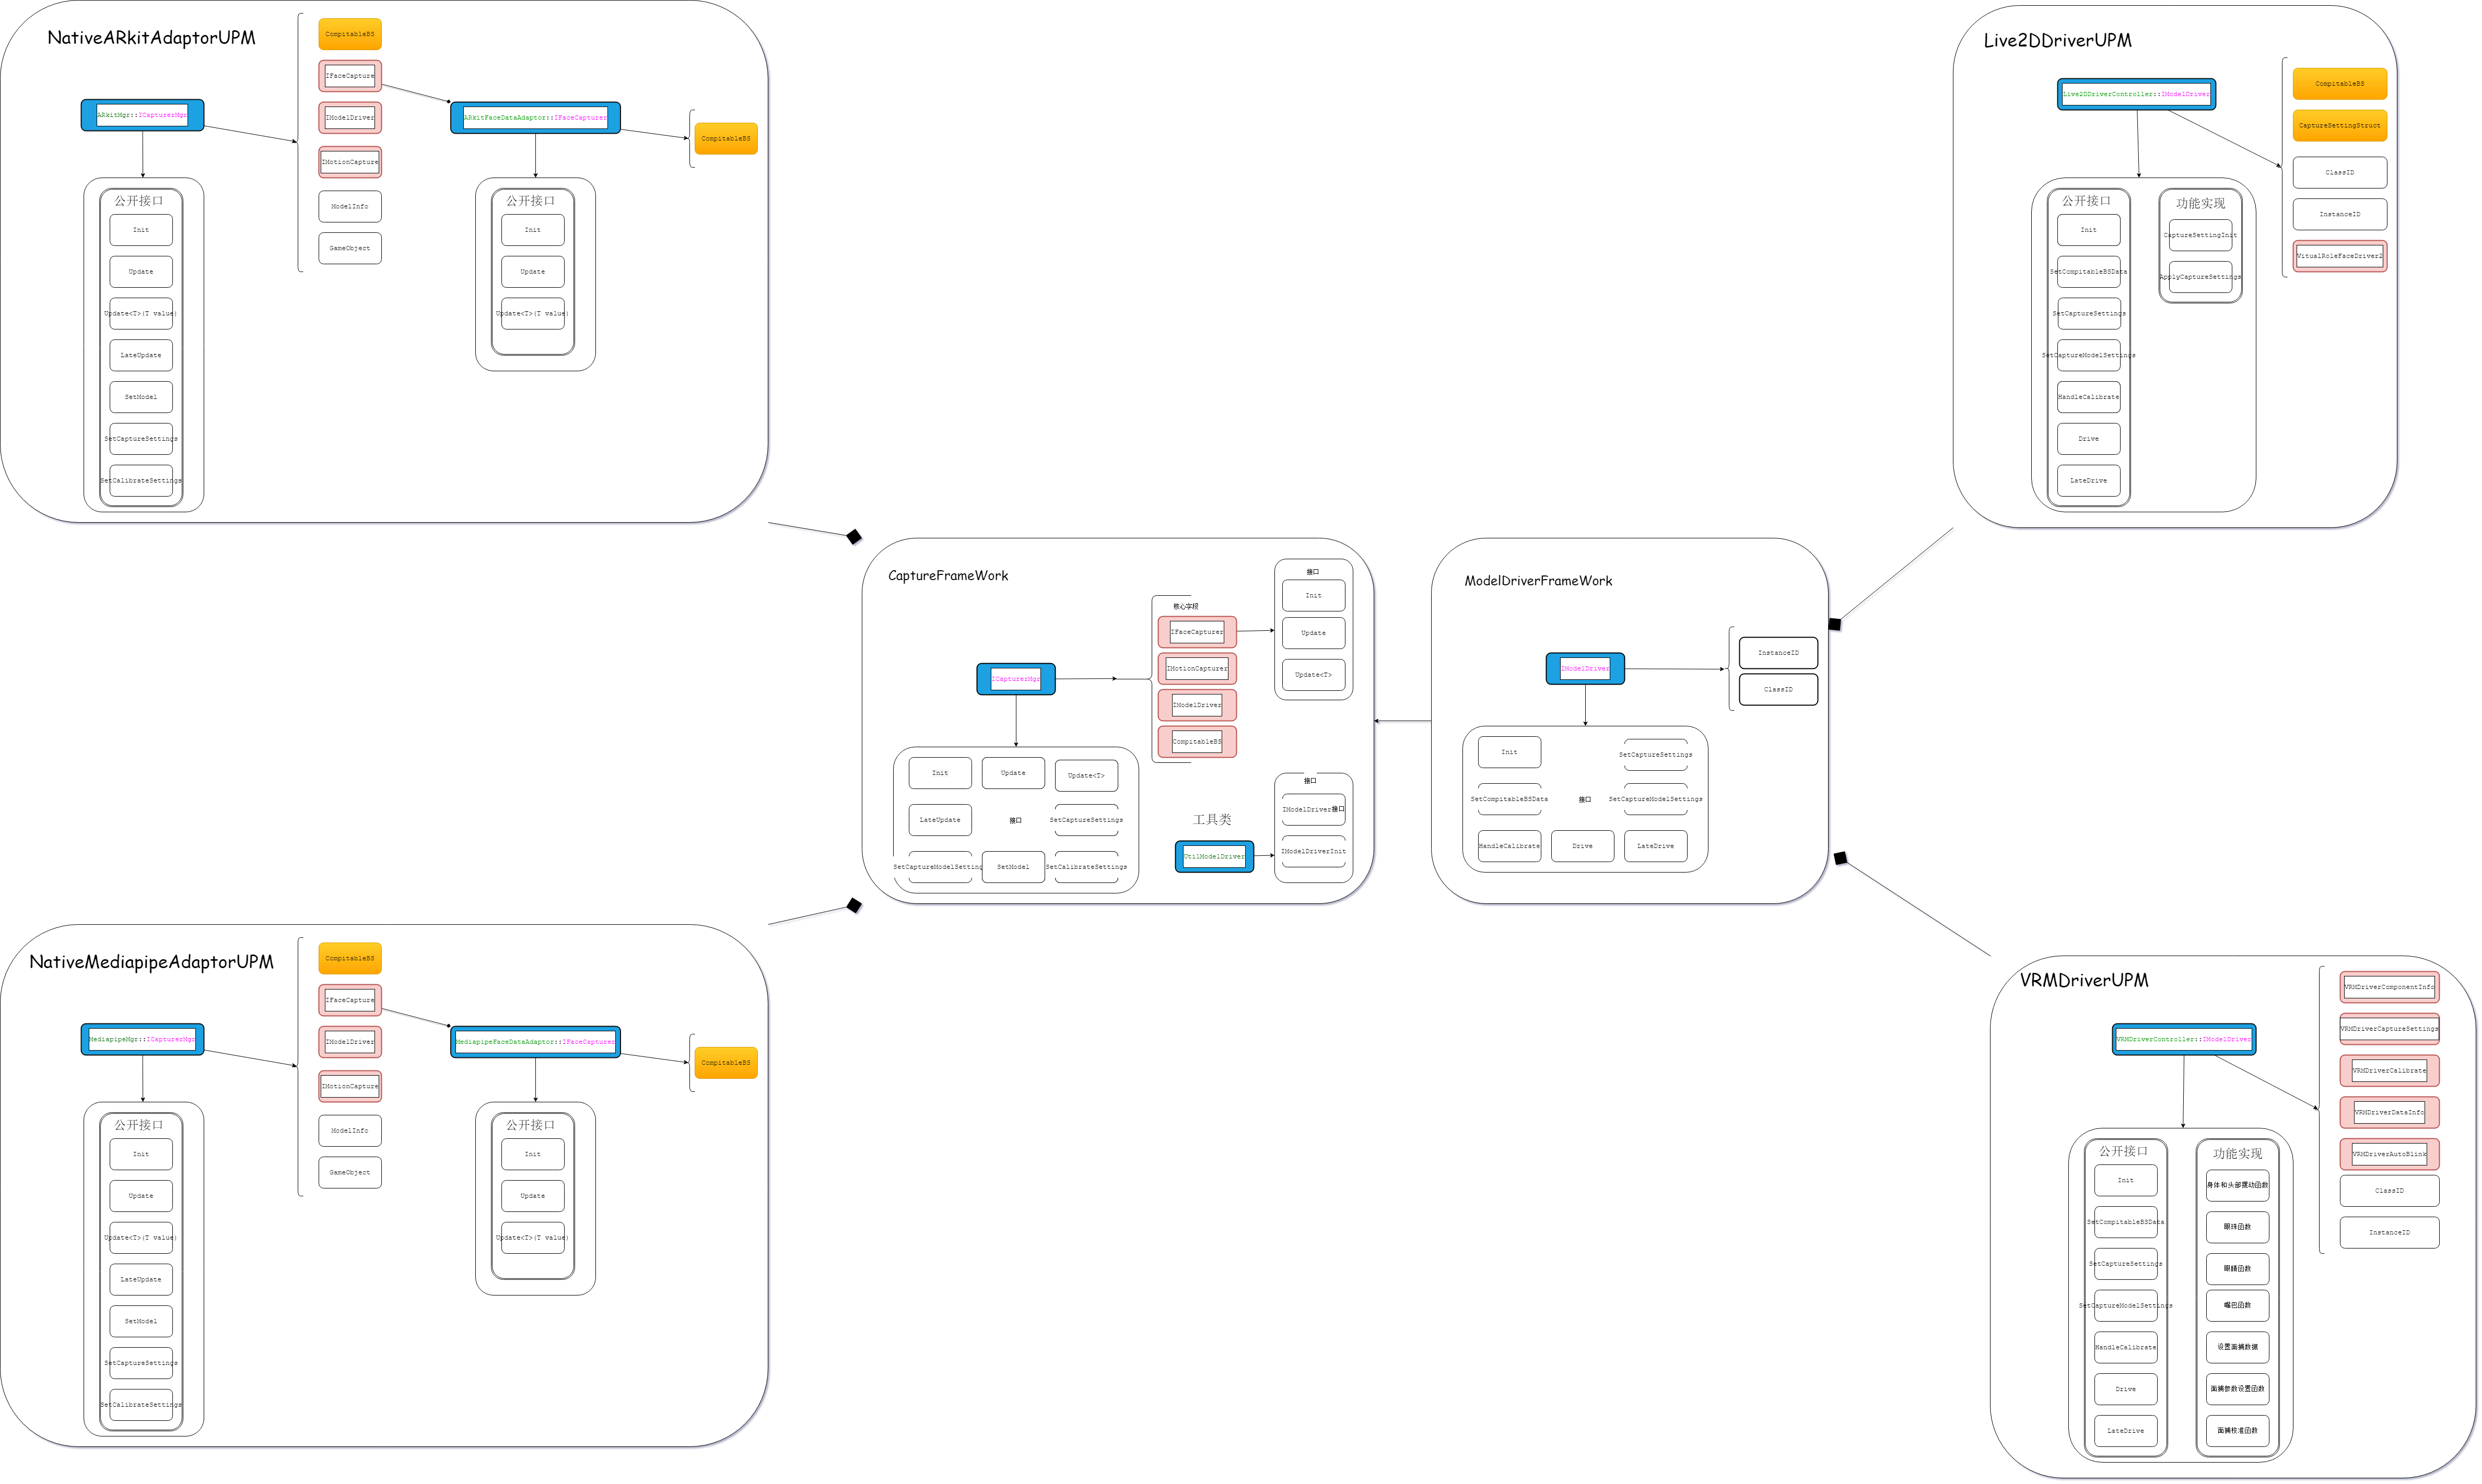
这套链路同时沉淀为面动捕 CM 框架(CaptureFrameWork + ModelDriverFrameWork),面捕引擎和驱动模型都可以插拔替换:
归纳算法:以眉毛为例
以眉毛上下为例,推导思路是:
- 取眉毛周围的特征点(图像识别提取预设范围内的点位);
- 确定基准特征点——即该表情通道权重为 0(完全未变化)时的点位状态;
- 计算眉毛上下带动的关键特征点与基准特征点之间的距离方差;
- 方差只是中间量,再经过一系列计算和参数调优,才得出最终的 BS 值。
嘴巴、眼睛、眼珠等模块同理:都是「关键点与基准点的几何关系 → 中间量 → 标定调参 → BS 权重」。这个方案不绑定 Mediapipe——只要别的框架用同一张人脸点位拓扑,算法可以直接平移。
眨眼推导链路
眨眼是调得最久的一个通道,完整链路:
上下眼睑距离 → 眨眼函数 → 分段函数(开合度阈值)
  → 卡尔曼滤波(平滑抖动) → 低通滤波(去高频噪声)
→ Lerp 插值(平滑过渡) → 输出稳定的 Blink BSpython
def blink_func(eye_aspect_ratio):
    if ear < OPEN_THRESHOLD:  # 眼睛闭合中
        return lerp(0, 1, (ear - CLOSED) / (OPEN_THRESHOLD - CLOSED))
    else:  # 眼睛完全睁开
return 0头部旋转推导
从鼻尖、眼角、嘴角等关键点位计算头部的 pitch / yaw / roll。推导出的旋转值不能直接赋给模型的 Head Bone——需要把模型的 localRotation 矩阵映射到 worldRotation 矩阵,否则模型姿态一偏旋转就错。
输出:15 个 BlendShape
眨眼(Blink)、张嘴(A)、微笑(I)、噘嘴(U)、嘟嘴(O)、噘嘴(E)、眼珠 X/Y、眉毛上下、特殊表情等,统一走 CompatibleFaceBlendShape 协议输出。
关键实现
双层滤波
- 卡尔曼滤波:作用在关键点位坐标层,预测 + 更新的标准实现,消除摄像头噪声和光照抖动;
- 低通滤波:作用在 BS 输出层,过滤头动和帧间差异导致的高频跳变。
两层滤波分工明确:点位层降噪保证推导输入干净,BS 层平滑保证驱动输出不抖。只滤一层都不够——只滤点位,推导过程会重新引入噪声;只滤 BS,误差已经被非线性推导放大了。
三条程序流程
- 主程序流程:各模块初始化 → 相机源捕获 → Mediapipe 引擎处理流 →
MediapipeAdaptor输出 blendshapes → 驱动模块。 - Mediapipe 引擎流程:
FaceMeshGraph Play→GraphRunner Initialize→CalculatorGraph Init→ImageSource Play→TextureFrameTool取图像数据给 Mediapipe 处理 → 输出Landmarks。 - 归纳模块流程:
Adaptor接收Landmarks→ 归纳模块 → 滤波模块 → 输出 blendshapes → 执行驱动。关键控制点:初始化是否完成、相机帧是否可用、Landmarks 是否有效、归纳/滤波后能否稳定输出。
指标
| 指标 | 数据 |
|---|---|
| 面捕模块 CPU 占用 | 50% → 10% |
| PC 端上线 | 2022-04-21,稳定运行至今 |
| 移动端上线 | 2022-08-31 |
| 落地项目 | A 级项目 3D 虚拟开播、Z-star |
| 实施产品 | 虚拟直播姬 PC 版、AR 头套开播 PC 版、虚拟直播姬移动端 |
| 专利 | 基于 Mediapipe 面部捕捉算法(已提交审核) |
复盘
- 引擎只解决一半问题。选 Mediapipe 时看重的是检测能力,但真正的工作量全在「点位 → 表情」这层没人做过的归纳算法上。评估开源方案要把这层成本算进去。
- 滤波要分层做。点位层卡尔曼、BS 层低通,各管各的噪声来源,比在单一层面上堆滤波器参数有效得多。
- 调参必须可视化。距离方差到 BS 的映射纯靠数值猜是调不出来的,得实时看着模型脸调。
- 当时的展望:BS 从 15 个扩到 52 个、滤波器进一步优化低延时和稳定性。